

endpoint 参数即可使用 webhook 投递,或一次性配置云端目标,让每个任务自动写入。所有抓取器的配置方式完全相同,只有 dataset_id 不同。
先决条件
- 拥有有效 API 密钥的 Bright Data 账户
- 熟悉异步请求流程
- 使用 webhook 时,需要一个可公开访问的 HTTPS 端点(或 webhook.site 等测试工具)
- 使用云端目标时,需要在对应账户中创建凭据的权限:Amazon S3 需要 IAM 角色,Google Cloud 需要服务账号密钥,Snowflake 需要用户和角色
我应该选择哪个投递目标?
云端目标在控制面板中抓取器的 Delivery settings 标签页一次性设置;webhook 通过endpoint 参数按请求设置。同一个任务可以同时使用两者。
文件格式为
json、ndjson(也标为 JSON lines)或 csv。
有两个选项会改变投递内容。流式投递在任务运行期间以每批 10 到 100,000 行发送结果;文件投递在记录旁附上每个页面的原始 HTML、WARC 或截图。两者都需要存储或 webhook 目标,不能使用 API 下载。详见如何流式传输结果并投递文件。
如何将结果投递到 webhook
当您在触发异步采集时提供endpoint URL,任务完成后 Bright Data 会向该 URL 发送包含抓取数据的 POST 请求,无需轮询。
步骤 1:设置测试 webhook
测试时,可使用 webhook.site 获取临时公开 URL:- 在浏览器中打开 webhook.site
- 复制页面显示的专属 URL(例如
https://webhook.site/abc-123-def) - 保持页面开启以监控收到的请求
步骤 2:使用 webhook URL 触发采集
在异步/trigger 请求中添加 endpoint 查询参数:
步骤 3:验证投递
采集完成后(少量记录通常需 30 到 60 秒),查看您的 webhook.site 页面,应能看到一条包含抓取数据的POST 请求。
该负载与直接通过 API 下载得到的 JSON 数组相同:
如何在生产环境中处理 webhook
在生产环境中,请将endpoint URL 指向您自己的服务器端点。
server.js
server.py
如何为 webhook 投递添加鉴权
如果您的端点需要鉴权,请添加auth_header 参数。Bright Data 会将其值作为 Authorization 标头随每次投递发送到该端点。已于 2026 年 9 月 7 日验证。本页早期版本将该参数写作 webhook_header_Authorization;API 会忽略该名称并在投递时不带 Authorization 标头,如果您复制过该写法,请替换。
投递请求带有哪些标头?
每次 webhook 投递都是一个POST 请求,带有 Content-Type: application/json; charset=utf-8、以 BRD dca-stage-deliver 开头的 User-Agent、存放快照 ID 的 dca-collection-id 标头以及标明文件名的 dca-filename 标头。请使用 dca-collection-id 将投递与任务对应,而不是解析请求体。于 2026 年 9 月 7 日观察到。
webhook 来自哪些 IP?
如果您的服务器使用 IP 允许列表,请添加以下 14 个 Bright Data webhook 源 IP。Bright Data 的所有异步 webhook 投递(涵盖 Scraper API、AI 爬虫和 SERP API)都来自其中之一。如何将结果投递到 Amazon S3
S3 投递在控制面板中按抓取器一次性配置。配置完成后,每个任务都会自动将结果写入您的存储桶。步骤 1:创建 IAM 策略和角色
Bright Data 通过担任您 AWS 账户中的 IAM 角色向存储桶写入。创建允许写入的策略、Bright Data 投递角色可以担任的角色,并将角色附加到存储桶。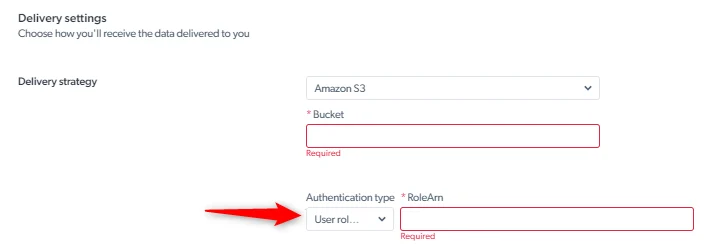
1
创建策略
在 IAM 控制台打开策略,创建允许对存储桶执行 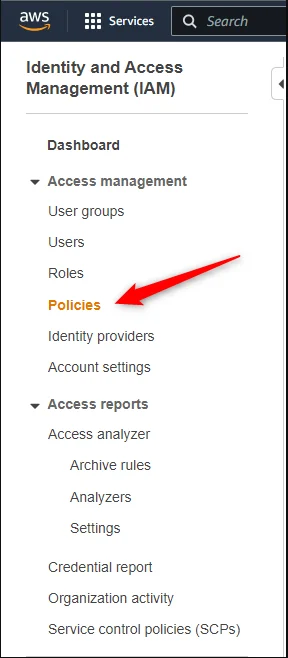
PutObject 和 GetObject 的策略。2
创建角色
打开角色,创建角色,并在权限策略下附加第 1 步的策略。记下角色的 ARN,形如 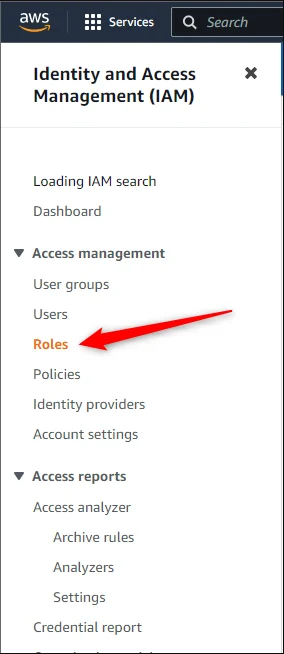
arn:aws:iam::<ROLE_ID>:role/<ROLE_NAME>,需填入投递设置。3
将角色附加到存储桶
在存储桶上通过 ARN 授予第 2 步创建的角色访问权限。
步骤 2:配置投递目标
- 进入您的抓取器配置页
- 点击 Delivery settings 标签页
- 选择 Amazon S3 作为投递目标
- 填写您的凭据:
- Bucket name:您的 S3 存储桶名称
- Role ARN:步骤 1 中创建的 IAM 角色 ARN
- External ID:角色信任策略中的外部 ID
- Region:您的 S3 存储桶所在区域
- Path prefix(可选):存储桶内的文件夹路径(例如
linkedin/profiles/)
- 选择所需的文件格式(JSON、NDJSON 或 CSV)
- 点击 Save
步骤 3:触发采集
按常规方式触发异步采集,无需额外参数,结果会自动投递到您的 S3 存储桶:步骤 4:验证投递
采集完成后,检查您的 S3 存储桶中是否已生成文件:sd_m1a2b3c4d5e6f7g8h.json)。下载并查看:
如何将结果投递到 Google Cloud Storage
Google Cloud Storage 投递使用服务账号密钥进行身份验证。创建密钥后,将其中的私钥粘贴到抓取器的投递设置中。- 打开 Google Cloud 控制台,展开菜单并打开 IAM 和管理。
-
点击服务账号。
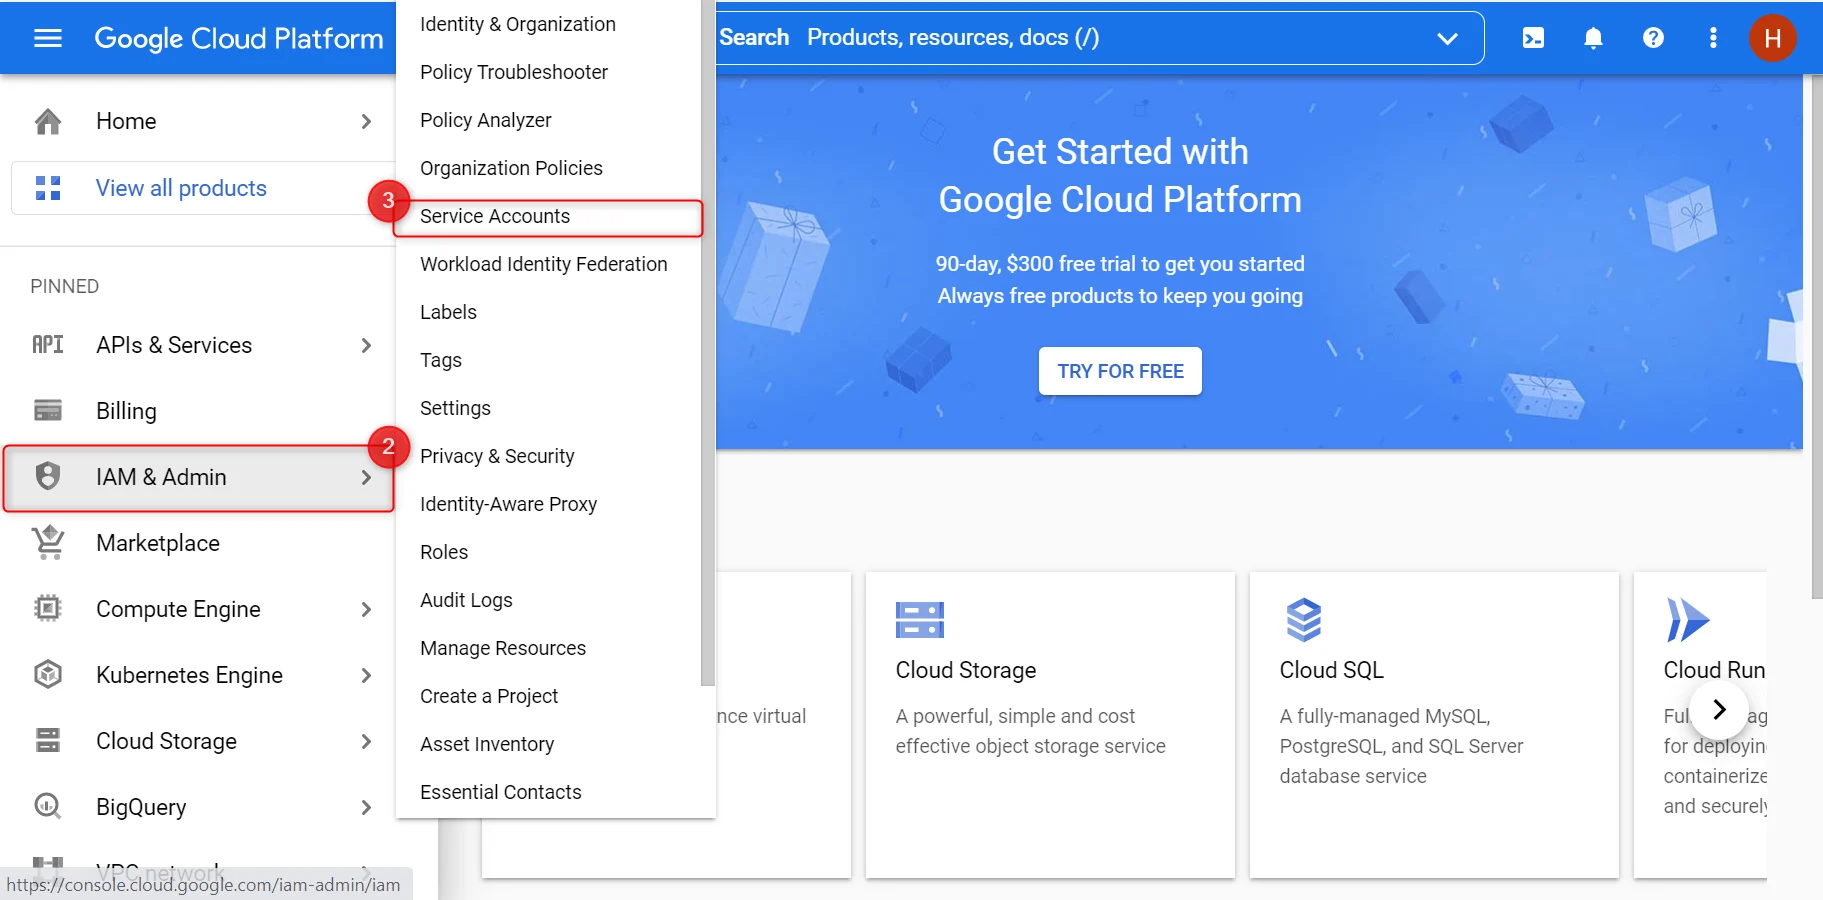
-
选择已有服务账号或新建一个。如果没有该按钮,请先创建项目。
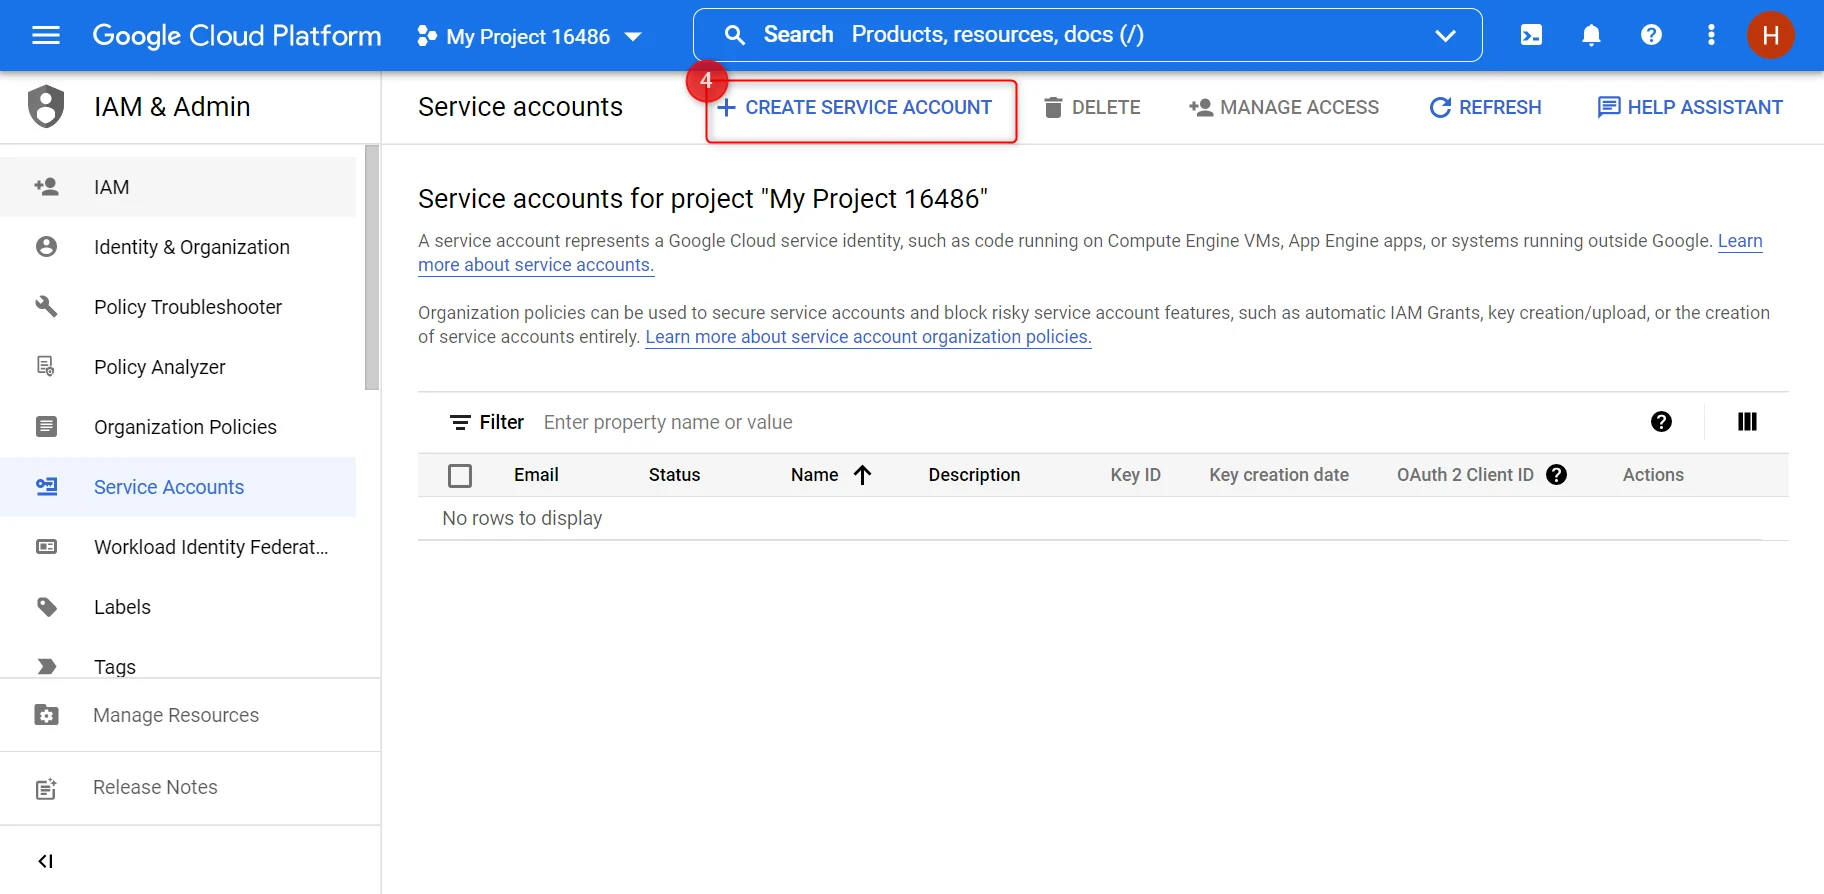
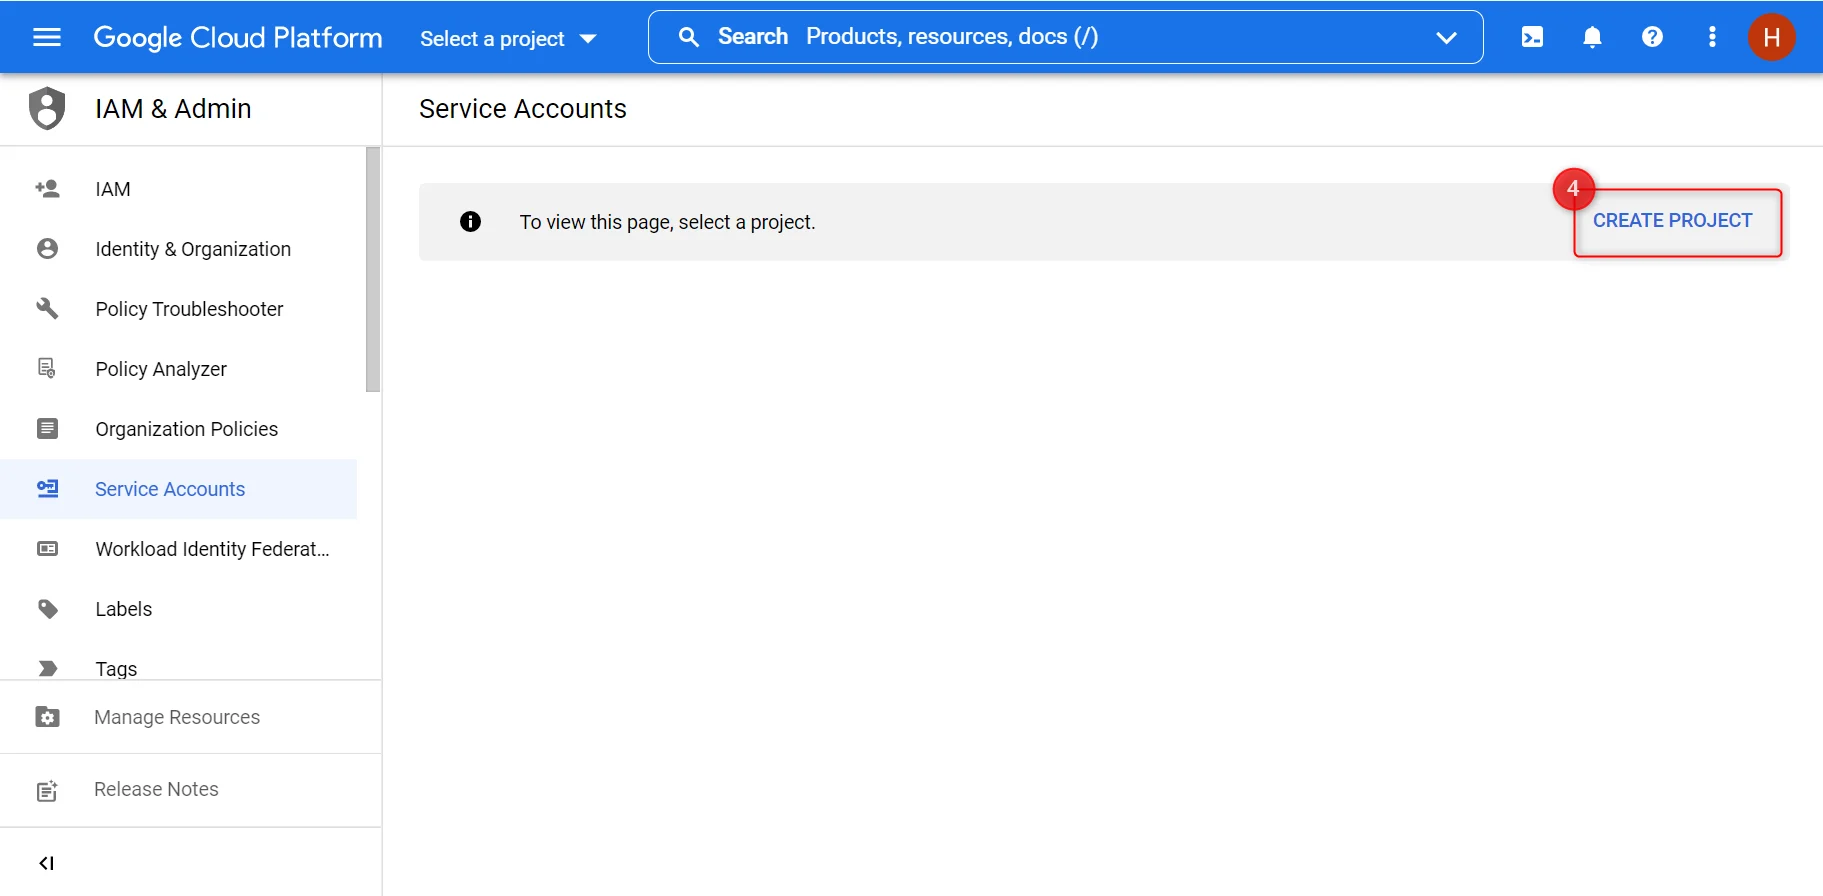
-
输入名称、ID 和说明,授予账号访问存储桶的权限,然后创建。
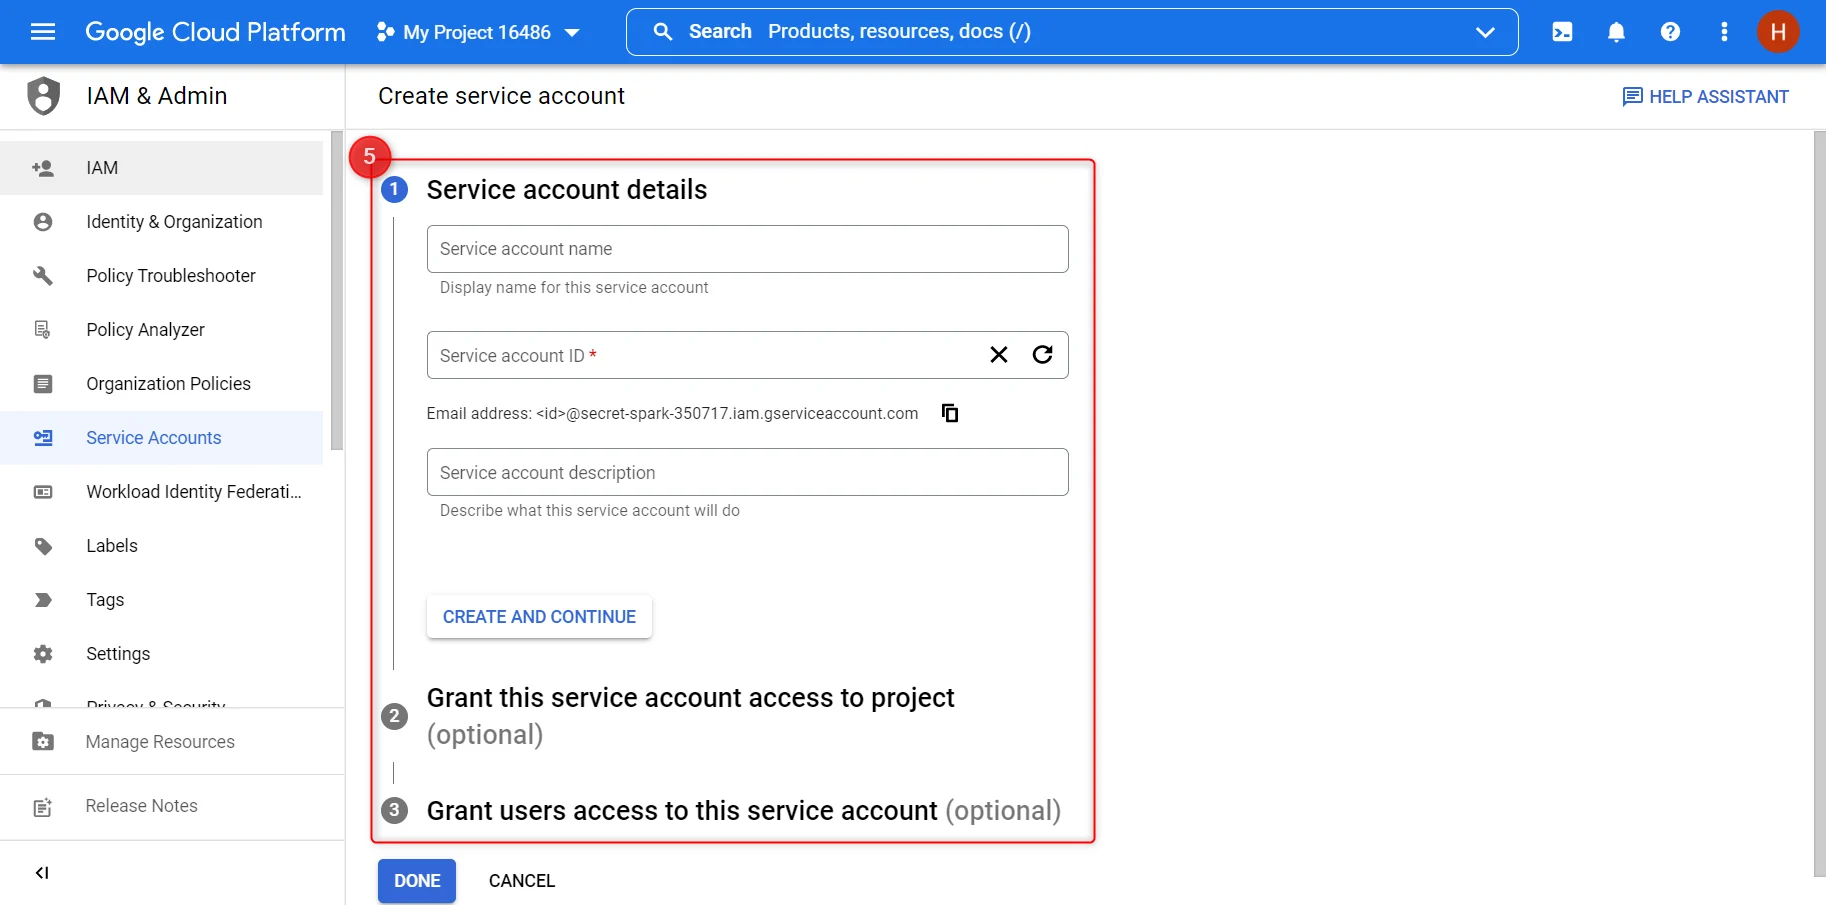
-
点击服务账号的邮箱地址。
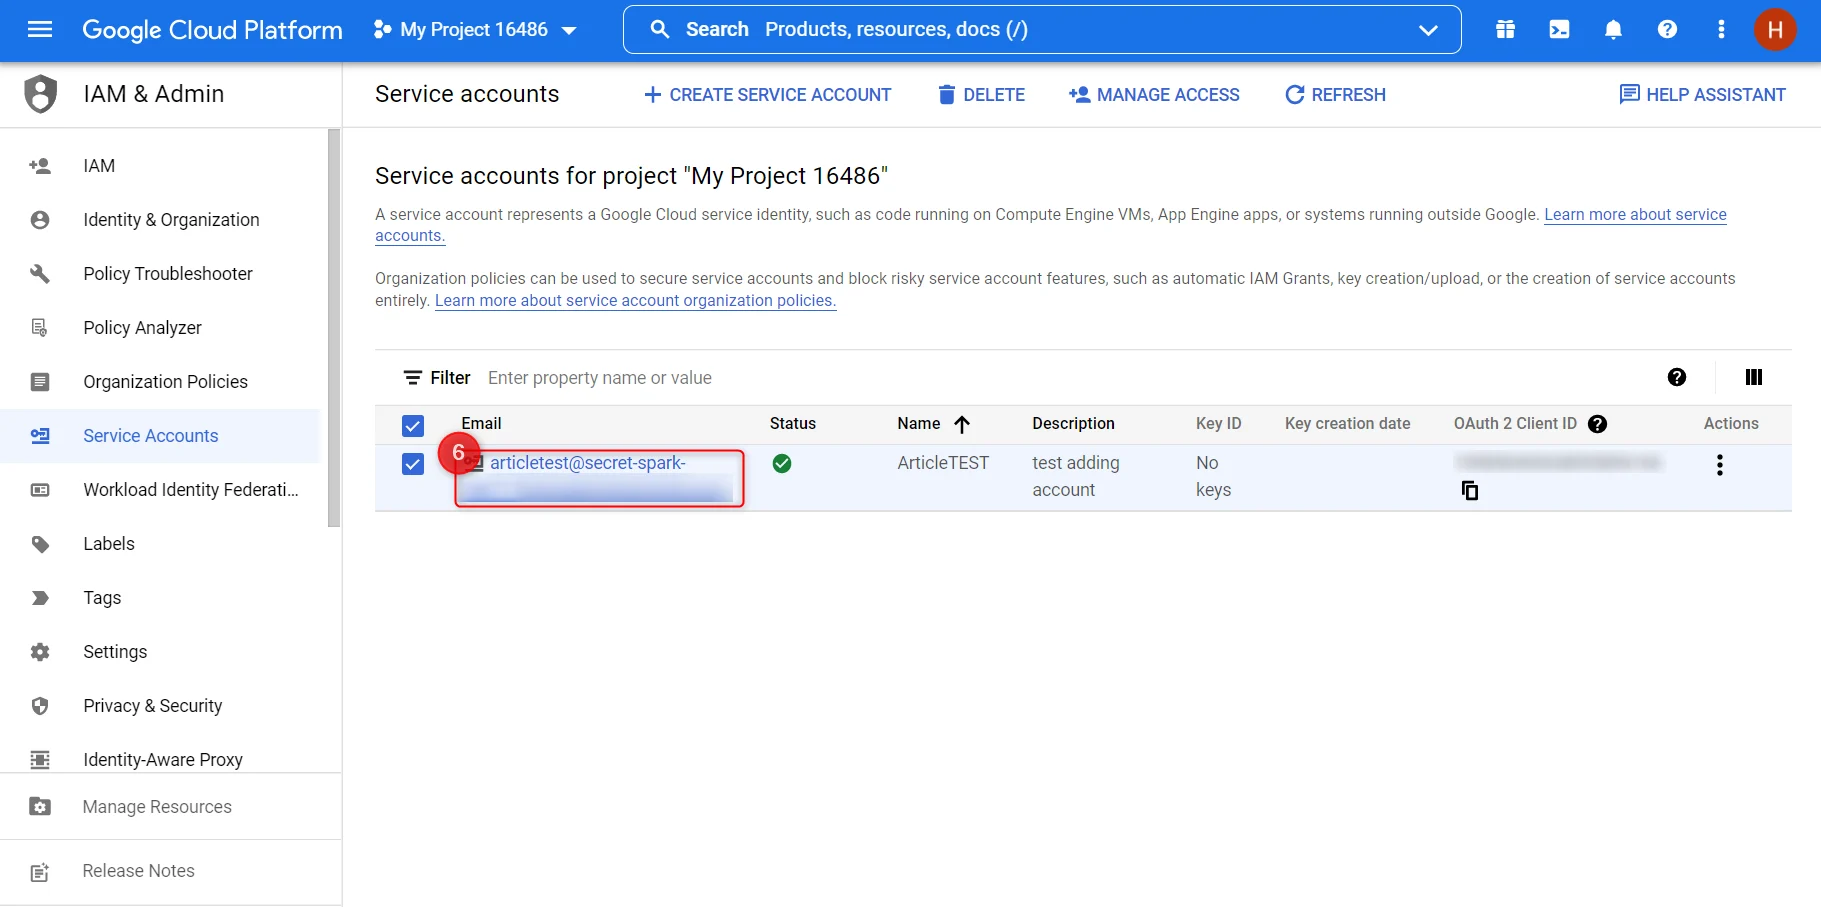
-
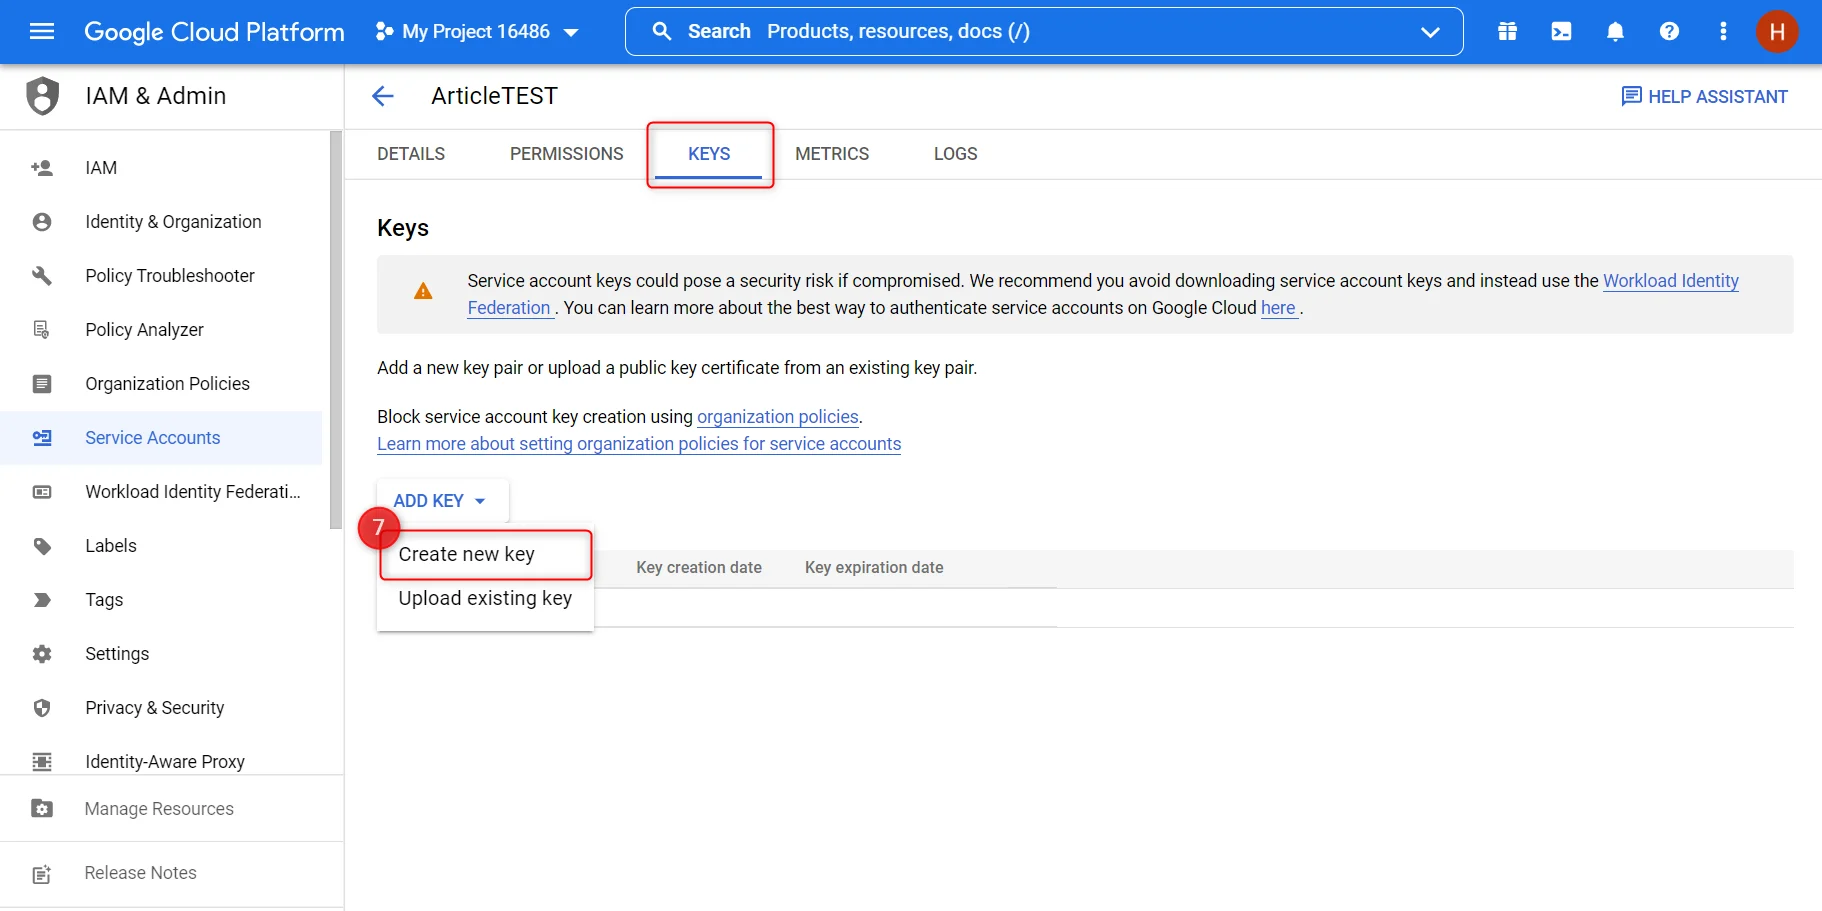
打开密钥标签页,点击添加密钥,再点击创建新密钥。
-
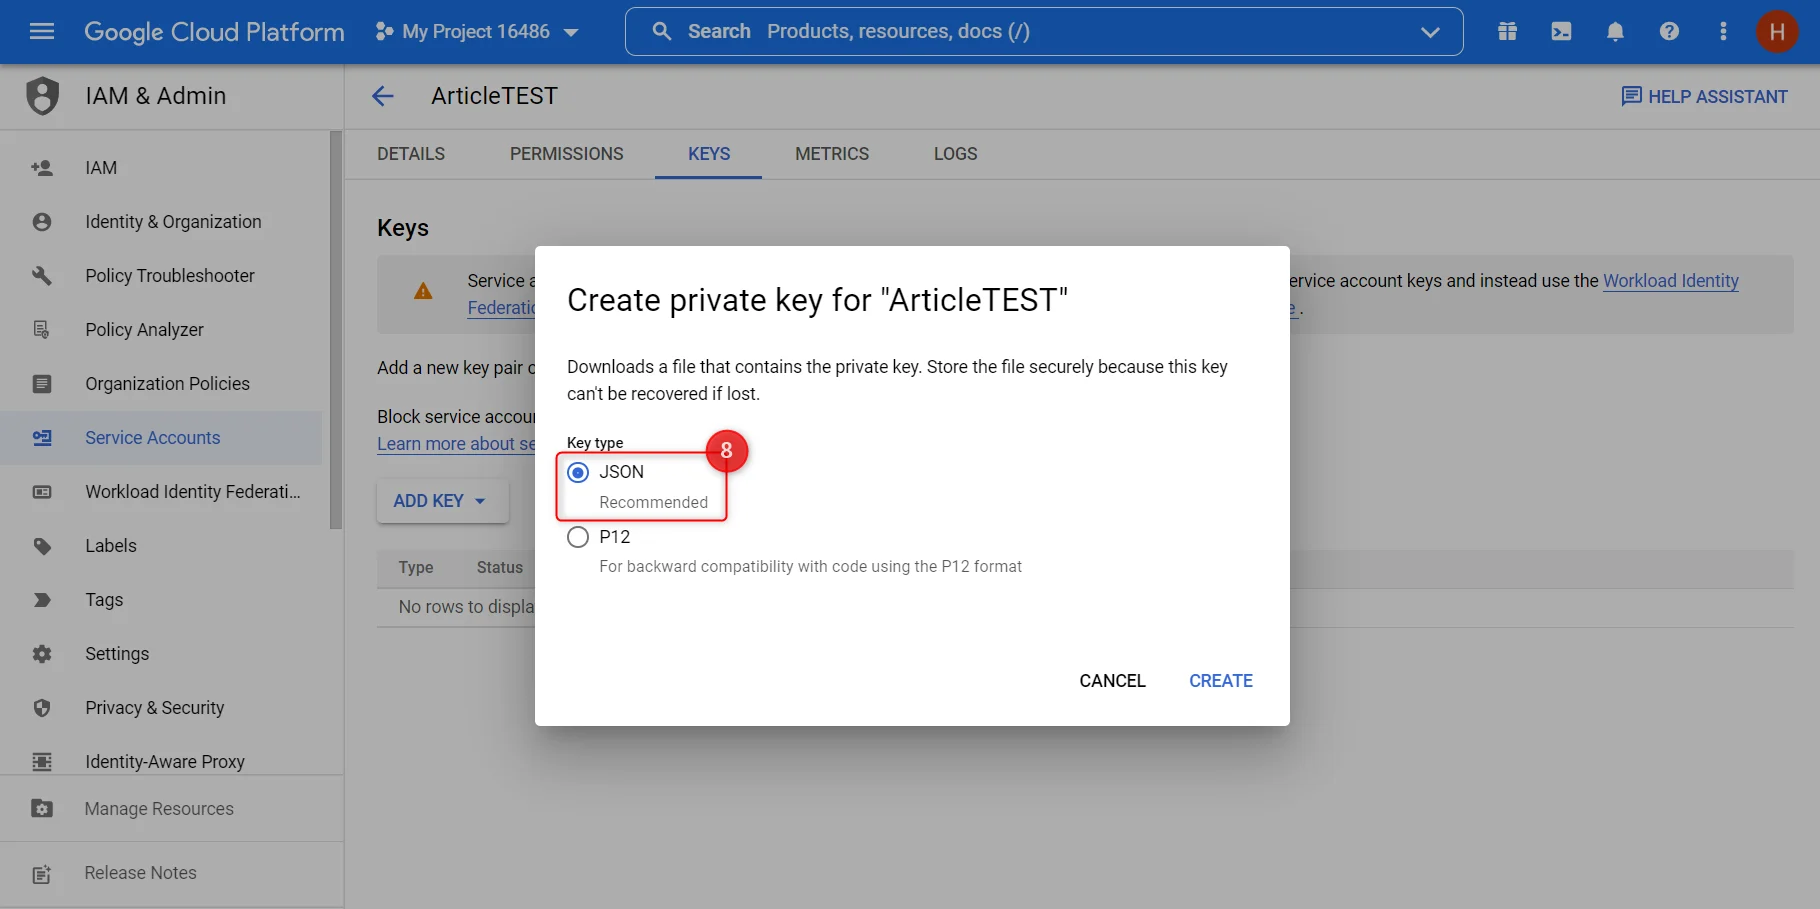
选择 JSON。密钥文件会下载到您的计算机。
-
将下载文件中的
private_key值复制到抓取器的投递设置中,并填写存储桶名称和文件格式。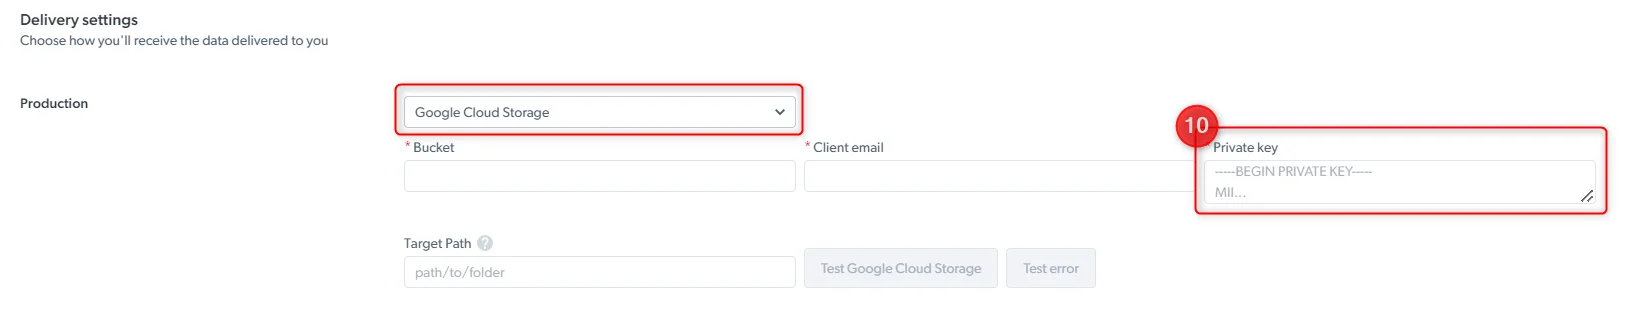
如何将结果投递到 Snowflake
Bright Data 通过内部命名 stage 加载数据,使用您为其创建的用户和角色。在您的 Snowflake 账户中运行以下命令,然后在抓取器的投递设置中填入这些值。1
选择或创建数据库
2
选择或创建 schema
每个数据库都有
PUBLIC schema。若要使用其他 schema:3
选择或创建仓库
Snowflake 关于数据加载仓库大小的建议同样适用;参见 Warehouses overview。
4
选择或创建内部命名 stage
5
创建可写入 stage 的角色
6
为 Bright Data 创建用户并授予角色
7
如使用网络策略,请将 Bright Data 的 IP 加入白名单
如果账户启用了网络策略,请添加以下四个地址:
故障排除
Webhook 收不到数据?
- 确认该 URL 可公开访问(不能是
localhost) - 确认您的端点在 30 秒内返回
200状态码 - 如果有防火墙规则,请确认上述 14 个 webhook IP 已加入允许列表
收到的是压缩数据?
若省略uncompressed_webhook=true,数据将以 gzip 压缩形式送达。请在触发 URL 中添加 uncompressed_webhook=true,或在服务器端解压负载。
负载超出服务器处理能力?
大型采集的负载最高可达 1 GB。请在 Express.js 中设置express.json({ limit: "100mb" }),或在您所用框架中做等效配置。对于超大数据集,请改用 S3 投递。
S3 中没有出现文件?
- 确认 IAM 角色 ARN 和外部 ID 正确
- 确认存储桶策略允许来自 Bright Data 账户的
s3:PutObject - 确认存储桶区域与配置一致
- 在 Bright Data 控制面板的 Logs 中查看投递状态
S3 出现 Access denied 错误?
请确认 IAM 角色的信任策略指向 Bright Data 账户422310177405 中的投递角色,且信任策略中的外部 ID 与投递设置中填写的一致。
常见问题
各平台的投递配置有区别吗?
没有区别。所有 Bright Data 抓取器的 webhook 参数和云端目标配置完全相同,只有触发请求中的dataset_id 不同。
可以同时使用 webhook 和云存储吗?
可以。云端投递在控制面板中按抓取器配置,而endpoint 参数按请求设置,因此单个任务可同时使用两者。
任务完成时我的 webhook 不可用会怎样?
Bright Data 会重试投递。如果您的端点持续不可用,可使用触发调用返回的snapshot_id 直接下载快照,快照保留 30 天。