

开始使用
什么是 Scraper API?
Bright Data Scraper API 通过数千个预构建爬虫按需从网站提取最新数据。您发送 URL 或搜索输入,API 返回结构化的 JSON、NDJSON 或 CSV 记录。用它自动化数据采集并对接其他系统,无需编写或维护爬虫。如何开始?
开通 Bright Data 账户,在账户设置中创建 API 密钥,然后按照目标网站的快速开始操作。第一个请求只是一次POST 调用。
如何进行身份验证?
在每个请求的Authorization 标头中发送 API 密钥:
如何在不写代码的情况下测试爬虫?
在控制面板中打开爬虫,输入您的输入项,选择同步或异步模式以及投递方式,然后从代码示例面板复制生成的代码。该面板中已预填数据集 ID。使用 webhook.site 或 Postman 这样的工具即可运行。什么是数据集 ID,在哪里可以找到?
数据集 ID 标识一个爬虫,放在每个请求的dataset_id 查询参数中,形如 gd_l1viktl72bvl7bjuj0。可在两处找到:
- 在控制面板中打开爬虫时的浏览器地址栏:
/cp/scrapers/gd_...。 - 爬虫”配置”标签页的代码示例面板中,已预填在 cURL 命令里。
sd_ 开头的 ID(例如 sd_m7hm4et0141r2rhojq)是快照 ID,不是数据集 ID。快照是一次请求采集到的数据。
哪些网站有爬虫?
数千个预构建爬虫覆盖 LinkedIn、Instagram、TikTok、亚马逊、Google 地图等众多网站。可在控制面板浏览完整列表;使用最多的十个平台有各自的文档。对于没有爬虫的网站,可用 Scraper Studio 构建,或咨询托管服务。采集型与发现型爬虫有什么区别?
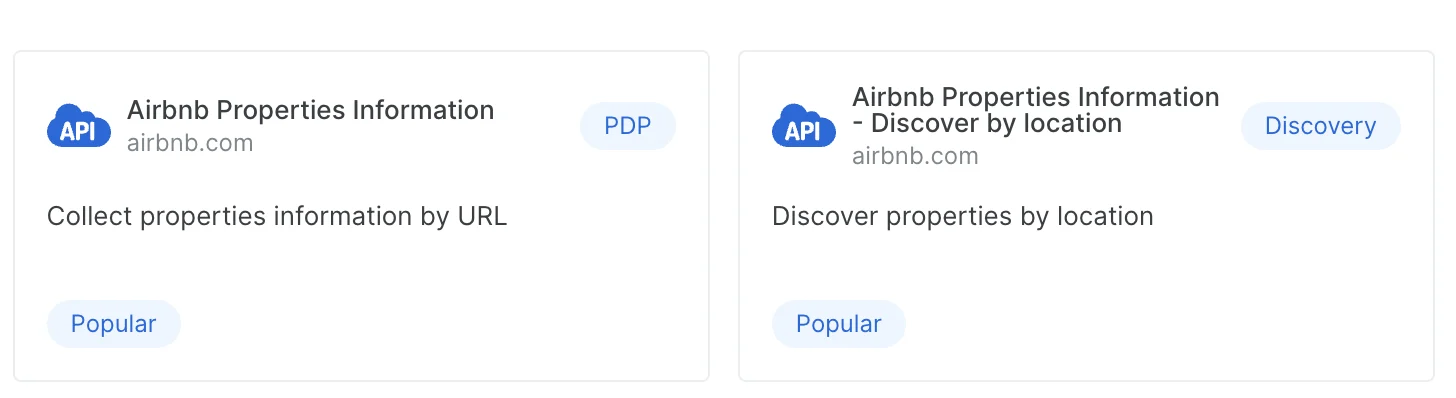
每个爬虫接受不同的输入。分为两类:- **采集型(Collect)**爬虫接受 URL,提取每个 URL 背后的详情页:商品规格、价格、个人资料字段。
- **发现型(Discover)**爬虫根据关键词、分类 URL 或位置等搜索输入查找新记录,然后采集每条结果。同一网站可以有多个发现型爬虫,每种搜索方式一个。
请求与结果
控制面板中的”同步”和”异步”有什么区别?
这两个标签对应两个 API 端点:
同步请求最多等待 1 分钟。如果作业需要更长时间,响应为 HTTP
202 并带有 snapshot_id,作业转为异步继续。详见了解同步与异步请求。
Scraper API 有多快?
响应时间取决于目标网站和爬虫负载,Bright Data 不公布固定数值。少量 URL 的采集型爬虫通常在 1 分钟同步窗口内返回。发现型爬虫需要访问多个页面,耗时更长,请以异步方式运行。控制面板中每个爬虫的页面会显示其平均运行时间的参考值。支持哪些输出格式?
/scrape 和 /trigger 端点支持 json(默认)、ndjson 和 csv;通过 format 查询参数设置。投递到存储的文件还可以是 jsonl。
快照为空意味着什么?
空快照没有可用记录,但通常仍包含说明原因的错误记录:无效输入、访问受限,或 404、商品已下架等失效页面。在请求中添加include_errors=true 即可查看。
快照可保留多久?
作业完成后 30 天。可通过下载快照端点凭快照 ID 下载,或投递到存储或 webhook。管理快照
在哪里获取快照 ID?
POST /datasets/v3/trigger 的响应会返回一个。运行超过 1 分钟的同步请求也会在其 202 响应中返回。使用获取快照可列出账户下的所有快照。
如何取消正在运行的快照?
向/datasets/v3/snapshot/{snapshot_id}/cancel 发送 POST:
可以重新运行失败的快照吗?
可以,使用重新运行快照端点:如何取回我发送的输入?
调用获取快照输入:notify URL 和 webhook 端点有什么区别?
notify URL 在作业完成时收到一条简短的状态消息:快照 ID 及其状态,不含数据。endpoint URL 在快照就绪后直接收到数据本身。用 notify 触发您自己的下载;用 endpoint 让 Bright Data 推送记录。详见如何将结果投递到 webhook 或 S3。
投递快照
以下问题涉及投递快照端点POST /datasets/v3/deliver/{snapshot_id},它将已有快照推送到存储目标。
响应中的投递任务 ID 怎么用?
响应中的id 是投递任务 ID。轮询 GET /datasets/v3/delivery/{delivery_id},直到状态为 done。
快照需要处于特定状态吗?
需要,必须为ready。请先用 GET /datasets/v3/progress/{snapshot_id} 检查。可能的状态为 starting、running、ready、failed 和 canceled。对每个目标各调用一次该端点,即可将同一快照投递到多个目标。
如何让投递文件不超过大小限制?
每个投递文件的硬性上限为 5 GB。用batch_size 设置每个文件的记录数:用 5 GB 除以平均记录大小,从较低值开始,再根据实际收到的文件大小调整。记录约 5 KB 时,batch_size 为 1,000,000 正好触及上限,因此建议从 500,000 左右开始。该端点返回 400 最常见的原因是 batch_size 生成的文件超过 5 GB。设置 compress: true 可接收 gzip 压缩文件。
计费与套餐
有免费试用吗?
每个新 Bright Data 账户每月获得 5,000 个免费信用额度,无需信用卡。Scraper API 每条记录消耗一个信用额度,因此该额度最多覆盖 5,000 条记录。信用额度每月 1 日重置。详见免费套餐。Scraper API 如何计费?
按交付记录计费。由于输入错误导致失败的记录仍会计费,因为请求消耗了资源。截至 2026 年 9 月,按量付费为每 1,000 条记录 $1.50,Scale 套餐超出包含额度后为每 1,000 条记录 $1.30。当前费率请查看价格页面或您的账户。如何升级套餐?
打开控制面板的账单部分并选择套餐。其他问题请联系支持团队。API 密钥过期了怎么办?
账户管理员在账户设置中创建新密钥。

平台限制与特定爬虫
特定爬虫或网站有限制吗?
有三个平台的限制值得在构建前了解:- Instagram:响应中的媒体链接在采集 24 小时后过期。请在此时间内下载所需媒体。
- TikTok:媒体仅可通过同一会话中生成的令牌访问,因此请保存记录而非媒体 URL。
- LinkedIn:帖子采集仅限个人资料公开显示的帖子,通常约 10 条。自 2025 年 11 月 13 日起,Position、Experience 和 Education 个人资料字段来自缓存;详见 LinkedIn Scraper API 简介。
有酒店数据的爬虫吗?
有。Google Scraper API 包含 Google Hotels 爬虫,可按 URL 采集酒店列表。对于库中未覆盖的网站,可用 Scraper Studio 构建自定义爬虫。如何抓取 Google 地图评价?
在控制面板中打开 Google 地图评价爬虫或从代码发送请求,传入地点 URL 和要获取评价的天数,然后运行并采集数据。Google Scraper API 端点页面展示了该请求。ChatGPT 爬虫是否在启用网络搜索的情况下运行?
网络搜索默认开启。在输入中传入web_search: false 可禁用,并读取响应中的 web_search_triggered 以确认是否执行了搜索。详见查询扩展与网络搜索控制。
可以查看爬虫背后的代码吗?
不可以。预构建爬虫是封闭的,代码无法查看或修改。想了解爬虫的工作原理,可在 Scraper Studio 中新建爬虫,它提供可阅读和改编的示例模板。选择合适的产品
哪个 Bright Data 产品能提供我需要的数据?
- 现成数据:数据集市场出售 Bright Data 已采集并定期更新的数据集。
- 受支持网站的最新数据:Scraper API 中的预构建爬虫按需返回记录。
- 其他网站的最新数据:在 Scraper Studio 中构建爬虫,或通过托管服务由 Bright Data 构建并运行。